En bref
- Une reconstruction échouée signifie rarement deux disques morts : généralement, un disque périmé et un disque avec des secteurs illisibles.
- Ne relancez pas la reconstruction, ne recréez pas la grappe et ne changez pas d’autres disques.
- En laboratoire, chaque disque est cloné et la grappe est reconstruite virtuellement, en écartant le membre périmé.
Pourquoi une reconstruction RAID 5 échoue
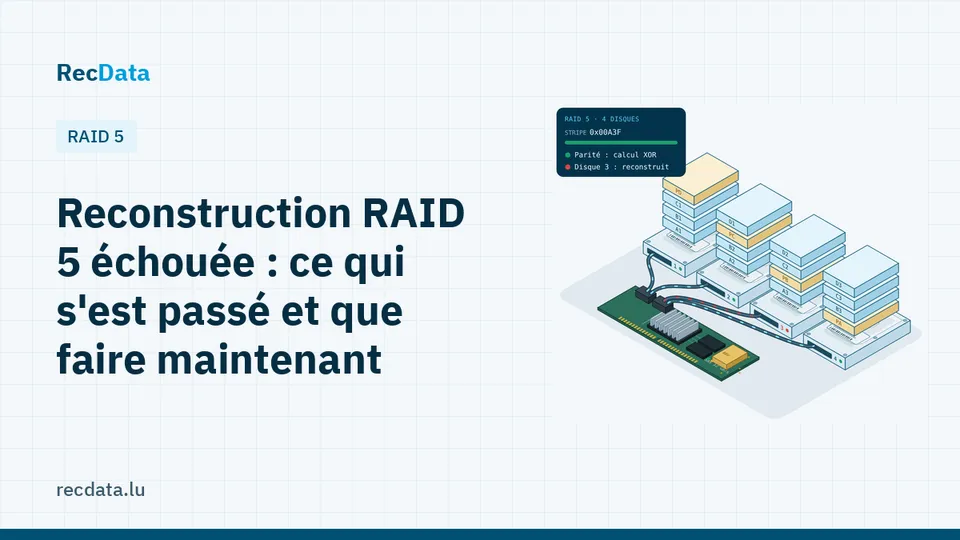
Quand un disque d’un RAID 5 lâche, le contrôleur ou le NAS continue de fonctionner en mode dégradé : chaque bloc manquant est recalculé à la volée à partir des autres disques et de la parité. Quand vous insérez un disque de remplacement, la reconstruction recalcule tout le disque manquant. Pour cela, elle doit lire chaque secteur de chaque disque restant, du premier au dernier.
C’est là que les choses se gâtent. Les disques d’une même grappe proviennent généralement du même lot, ont le même âge et ont fait le même travail. Si l’un a lâché, les autres ne sont souvent pas loin derrière. Les disques grand public sont spécifiés pour une erreur de lecture irrécupérable tous les 10^14 bits lus, soit environ tous les 12,5 To. Lire au complet quatre disques de 8 To entre largement dans cette plage : un seul secteur faible suffit à beaucoup de contrôleurs pour arrêter la reconstruction et mettre tout le volume hors ligne.
Les trois scénarios les plus courants
- Un deuxième disque avec des secteurs défectueux : la reconstruction tombe sur une zone illisible et s’arrête. Le disque n’est pas mort, seulement partiellement illisible.
- Un disque décroché depuis longtemps : la grappe était dégradée depuis des semaines sans que personne ne s’en aperçoive. Le disque qui « vient de lâcher » est en fait le deuxième, et le premier contient des données anciennes.
- Le mauvais disque retiré : un disque sain est retiré à la place du disque en panne, et la grappe a perdu deux membres d’un coup.
Ce qu’il ne faut pas faire
- Ne relancez pas la reconstruction. Chaque tentative relit le disque faible et peut transformer quelques secteurs défectueux en atterrissage de têtes.
- Ne forcez pas le retour en ligne d’un disque si vous ne savez pas quand il a quitté la grappe. Mélanger un ancien membre avec les membres à jour corrompt le système de fichiers sans bruit.
- Ne recréez pas et n’initialisez pas la grappe dans le contrôleur ou l’interface du NAS, même avec « les mêmes paramètres ».
- Ne lancez pas CHKDSK, fsck ni une fonction de « réparation » sur le volume dégradé.
- Étiquetez chaque disque avec son numéro d’emplacement avant de retirer quoi que ce soit.
Comment nous récupérons un RAID 5 en échec
1. Cloner chaque disque
Chaque disque est copié secteur par secteur sur un équipement qui ménage les zones faibles, en lisant d’abord les zones faciles et en revenant ensuite aux plus difficiles. Un disque en panne mécanique est d’abord réparé en salle blanche. À partir de là, vos disques d’origine ne sont plus touchés.
2. Trouver les paramètres
Sur les clones, nous déterminons l’ordre des disques, la taille des bandes (souvent 64 Ko sur les contrôleurs matériels, 64 ou 512 Ko avec Linux mdadm), la rotation de la parité (left-symmetric, right-asymmetric, etc.) et le décalage des données. Sur le RAID logiciel, les superblocs donnent directement l’essentiel, y compris un compteur d’événements qui montre quel disque a décroché en premier.
3. Reconstruction virtuelle
La grappe est assemblée par logiciel, en écartant le membre périmé. Là où le deuxième disque a des secteurs illisibles, les blocs manquants sont recalculés à partir de la parité des autres disques : tant que deux disques ne sont pas illisibles au même endroit, rien n’est perdu.
4. Système de fichiers et fichiers
Le volume est monté en lecture seule, le système de fichiers (NTFS, ext4, Btrfs, XFS, VMFS) est vérifié, puis les fichiers sont extraits. Vous recevez la liste des fichiers récupérés avant de payer.
Prévenir la prochaine fois
- Utilisez le RAID 6 ou le RAID 10 pour les grappes de plus de quatre ou cinq gros disques.
- Activez les alertes par e-mail pour qu’une grappe dégradée ne passe jamais inaperçue.
- Planifiez une vérification régulière des données (scrubbing) pour trouver les secteurs faibles pendant que la grappe est encore saine.
- Gardez une vraie sauvegarde : le RAID protège contre la panne d’un disque, pas contre une reconstruction ratée, une suppression ou un rançongiciel.
Pour les principes généraux, voir Le guide complet du RAID. Pour les NAS en particulier, voir Volume Synology planté ou pool de stockage dégradé et Pool de stockage QNAP inactif : causes et récupération.
Questions fréquentes
Un RAID 5 avec deux disques en panne peut-il être récupéré ?
Très souvent, oui. Deux disques sont rarement illisibles au même endroit : le disque périmé et celui qui a des secteurs défectueux se complètent une fois clonés.
Dois-je remplacer le deuxième disque en panne et relancer la reconstruction ?
Non. Sans copie complète du disque faible, une deuxième reconstruction peut l’achever. Éteignez la grappe et faites d’abord cloner les disques.
Combien de temps dure une récupération en laboratoire ?
De quelques jours à environ deux semaines, selon le nombre et la taille des disques et leur état. Les niveaux Standard (49 €) et Urgence (99 €, diagnostic sous 24 à 48 heures) sont disponibles pour les cas urgents.
Sources officielles et liens utiles
- Wiki Linux RAID (kernel.org) : documentation de référence du RAID logiciel Linux (mdadm).
Vos données sont importantes ?
N’essayez rien qui pourrait aggraver la panne. Le diagnostic est gratuit et vous recevez un devis à prix fixe avant tout travail.
Demander un diagnostic gratuit Récupération de données RAID 5